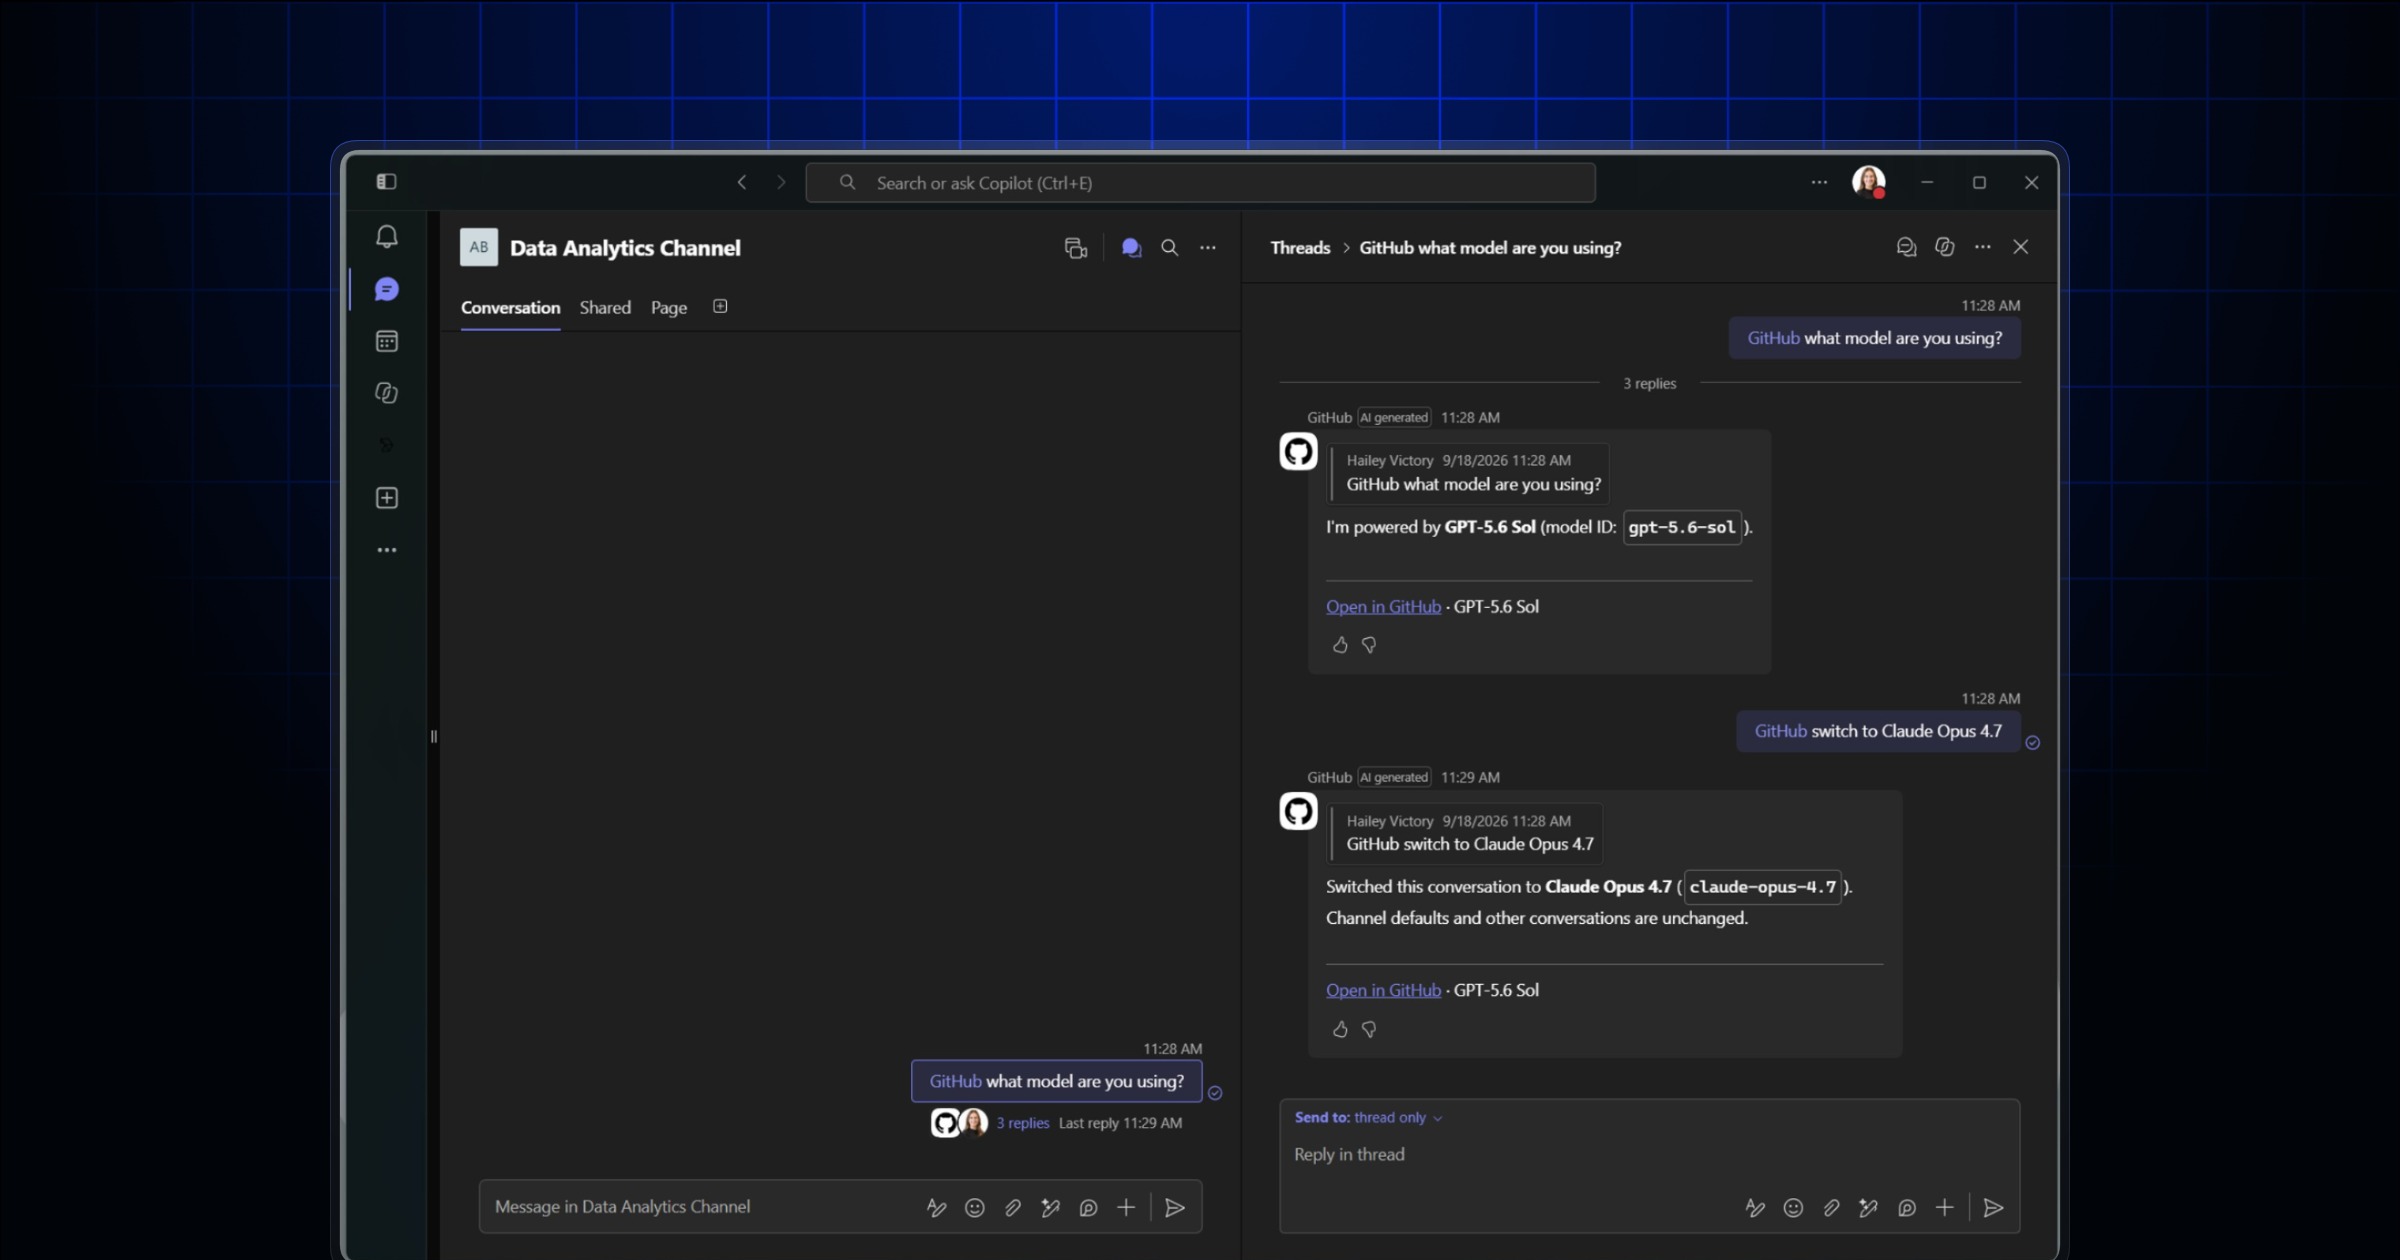
GitHub cập nhật Copilot cho Slack và Microsoft Teams
GitHub công bố cập nhật Copilot cho Slack và Microsoft Teams, đáng chú ý với đội vận hành đang đưa trợ lý AI vào kênh cộng tác kỹ thuật.
Chuyện gì vừa xảy ra
GitHub công bố cập nhật Copilot cho Slack và Microsoft Teams, đáng chú ý với đội vận hành đang đưa trợ lý AI vào kênh cộng tác kỹ thuật.
Thông báo đến từ GitHub Changelog và có mốc sản phẩm rõ ràng. Với đội sysadmin, đây là loại tin cần được đưa vào quy trình theo dõi thay đổi: không chỉ xem tính năng mới là gì, mà phải hiểu nó có thể tác động tới cách triển khai, giám sát, phân quyền, cache, backup hoặc kiểm soát rủi ro trong production.
Ai bị ảnh hưởng
Các tổ chức đang dùng dịch vụ, API hoặc thành phần liên quan nên kiểm tra lại inventory. Với cloud và edge platform, phạm vi thường gồm zone, worker, cache rule, pipeline deploy, token truy cập và dashboard quan sát. Với Kubernetes, cần đối chiếu phiên bản cluster, feature gate, storage class, chính sách tài nguyên và workload có yêu cầu bảo mật cao. Với GitHub, cần rà lại automation, báo cáo nội bộ và quyền của agent trong repository.
Tác động vận hành
Thay đổi mới từ vendor có thể làm lệch giả định hiện tại của đội vận hành. Một runtime mới hoặc môi trường preview mới có thể giúp giảm rủi ro deploy, nhưng cũng cần policy rõ về ai được tạo preview và dữ liệu nào được phép đưa vào đó. Một thay đổi về cache hoặc HTTP header có thể cải thiện hiệu năng, đồng thời tạo bug khó phát hiện nếu cache key không phản ánh đúng biến thể nội dung. Các cập nhật Kubernetes thường cần đọc kỹ release note trước khi bật trên cluster dùng chung.
Nếu môi trường production có thành phần liên quan, đội phụ trách nên tạo ticket review thay vì thay đổi nóng. Ticket nên ghi rõ dịch vụ nào bị ảnh hưởng, owner là ai, trạng thái hiện tại, test cần chạy trên staging và rollback plan nếu kết quả không như kỳ vọng.
Điểm sysadmin cần theo dõi
- Đọc thông báo gốc và lưu lại mốc thời gian, phiên bản hoặc dịch vụ liên quan.
- Đối chiếu với inventory, dashboard, CI/CD pipeline, policy bảo mật và runbook hiện có.
- Kiểm tra xem thay đổi có phá script, báo cáo, cache rule, backup job hoặc kiểm soát quota hay không.
- Theo dõi cập nhật tiếp theo từ GitHub Changelog trước khi áp dụng rộng trên production.
Kết luận
Tin này không nhất thiết yêu cầu hành động khẩn cấp ở mọi hệ thống, nhưng nên được đưa vào backlog vận hành. Với hạ tầng production, chậm theo dõi các thay đổi nhỏ từ vendor thường là nguyên nhân khiến sự cố xuất hiện muộn: dashboard sai, quyền bị mở rộng quá mức, cache trả nhầm nội dung hoặc workload mới không tương thích với policy cũ.